卒論イメージ1:\(x\)が\(y\)に与える影響に関する実証研究(サンプル6,000字程度)
要旨 (Abstract)
本文がすべて書き終わってから書く。本文に変更があるとここも書き換えないといけなくてムダなので最後に書く。
本研究の目的は、日本の上場企業を対象に、説明変数\(x\)が結果変数\(y\)に与える影響を実証的に明らかにすることである。近年、経営環境の変化に伴い\(y\)の重要性が高まっているが、その決定要因に関する議論は尽くされていない。本研究では、20XX年から20XX年までの財務データを用いた重回帰分析を行った。分析の結果、\(x\)は\(y\)に対して統計的に有意な正の影響を与えることが明らかになった。この結果は、企業規模や財務レバレッジといった他の要因を制御しても頑健であった。本研究の知見は、経営者が\(y\)を向上させるための施策として、\(x\)の導入および強化が有効であることを示唆しており、実務上重要な含意を提供するものである。
以下のx, y, zは適宜自分の変数に置き換え、そのままは使わないこと。
1. 序論
1.1 研究の背景と目的
近年、わが国の企業経営において、\(y\)の向上は極めて重要な経営課題として認識されている。グローバル競争の激化やステークホルダーからの要請を背景に、多くの企業が\(y\)の水準を高めるための模索を続けている。 こうした中、実務の現場やビジネスメディアにおいては、\(y\)を促進するドライバーとして\(x\)に注目が集まっている。例えば、先進的な取り組みを行う一部の企業では、\(x\)を積極的に導入することで高い成果を上げている事例が報告されている。しかしながら、こうした事例はあくまで個別的な成功例にとどまり、統計的なデータに基づいて\(x\)と\(y\)の因果関係を検証した実証研究は、管見の限り十分に蓄積されていない。 そこで本研究では、日本の上場企業の財務データを用い、\(x\)が\(y\)に与える影響を定量的に検証することを目的とする。
1.2 本研究の意義
本研究の社会的意義は、経営者や実務家に対して、客観的なエビデンスに基づく意思決定の指針を提供する点にある。 \(x\)の推進には多大なコストや組織的な変革が伴う場合が多い。そのため、経営者にとって\(x\)への投資が本当に\(y\)の向上に寄与するのかという問いは、資源配分の観点から極めて切実である。本研究は、多数の企業データを用いた統計的分析によってこの問いに答えようとするものであり、\(y\)の改善を目指す企業にとって有用な示唆を与えうるものである。
2. 先行研究と仮説の導出
2.1 先行研究のレビュー
ここで先行研究3つは順にそれぞれ次のような立ち位置である。
- 先行研究A:自分の考える理屈と同じ結果を示している
- 先行研究B:自分の考える理屈とは異なるか、ずれた結果を示している
- 先行研究C:自分の考えるのと似た研究をしているが変数が違うとかで、自分の研究の必要性を際立たせるためのもの
よって、Aのタイプの先行研究が2つあれば「第一に」から始まる段落のような書き方を2回すればいいし、Cのタイプの先行研究が3つあれば「第三に〜」の段落と同じ書き方を3回すればいい。
\(x\)と\(y\)の関係に関する研究は、これまでにもいくつか行われている。以下では、代表的な3つの研究について、その目的、検証された課題、分析手法、使用データ、および得られた知見を概観する。
第一に、Name (Year) [先行研究Aのこと] は、\(x\)が組織のパフォーマンスに与える直接的な効果を検証することを研究目的とした。彼らは「組織における\(x\)の導入は、\(y\)を増加させるか」という研究課題を設定し、米国S&P500構成企業を対象とした10年間のパネルデータを用いて回帰分析を行った。その結果、\(x\)係数が正に有意であることを示し、\(x\)の強化が\(y\)の向上に寄与すると結論付けている。
第二に、Name (Year) [先行研究Bのこと] は、より慎重な見解を示している。\(x\)の効果が産業特性によって異なるとする〇〇理論の観点から、より詳細なメカニズムの解明を目的とした。彼らの研究課題は「競争環境の激しい産業において、\(x\)の効果は増幅されるか、あるいは減衰するか」という点にある。この課題に対し、欧州の製造業企業のデータを用い、産業競争度との交差項を含めた重回帰分析によって検証を試みた。分析の結果、競争が激しい環境下では\(x\)の効果が低減すると報告している。よって、彼らは\(x\)の効果は一様ではなく、環境要因に依存すると主張した。
第三に、本研究と同じく日本企業を対象とした研究として、Name (Year) [先行研究Cのこと] が挙げられる。彼らは「伝統的な日本的経営指標である\(z\)は、現在でも\(y\)を説明する主要因となりうるか」という問いを立て、東京証券取引所上場企業の財務データを用いた回帰分析を行った。その結果、\(z\)が依然として\(y\)に対し強い説明力を持つことが示された。しかしながら、この研究では財務指標のみに焦点が当てられており、非財務的な要因である\(x\)の影響については考慮されていない点に課題が残る。
以上の先行研究を総括すると、欧米のデータを用いた研究では\(x\)と\(y\)の関係について一定の知見が蓄積されているものの(先行研究 A, B)、日本企業を対象とし、かつ\(z\)などの財務要因をコントロールした上で\(x\)の影響を検証した研究(先行研究Cの発展形で自分が今からするもの)は十分になされていないといえる。
2.2 仮説の構築
以上の先行研究を踏まえ、本研究では日本企業の文脈において\(x\)と\(y\)の関係を再検討する。 先行研究Aが示唆するように、\(x\)が高い状態は、企業内部における情報の非対称性を緩和し、効率的な意思決定を促進する機能を持つと考えられる。具体的には、\(x\)が増加することで組織内の連携が強化され、無駄なコストが削減されるメカニズムが想定される。このメカニズムが有効に機能すれば、最終的な成果指標である\(y\)は高まるはずである。 先行研究Bのような慎重論も存在するものの、現代の日本企業が直面している経営環境においては、\(x\)がもたらすメリットがコストを上回ると推測するのが合理的である。 したがって、他の要因が一定であれば、\(x\)の水準が高い企業ほど\(y\)も高くなると予測される。以上より、本研究では以下の仮説を設定する。
仮説:企業における\(x\)の水準は、\(y\)に対して正の影響を与える。
3. 研究方法
3.1 データとサンプル選定
本研究では、仮説の検証を行うために、日本国内の上場企業を対象とした定量分析を行う。財務データおよび企業属性データについては、プロネクサス社が提供する企業情報データベース「eol」より抽出した。 分析期間は20XX年度から20XX年度までの5年間とする。この期間における全上場企業から、以下の基準に従ってサンプル選定を行った。第一に、規制産業であり財務諸表の構造が他業種と大きく異なる金融・保険業に属する企業を除外した。第二に、変数の構築に必要な財務データに欠損がある企業を除外した。これらの手続きを経た結果、最終的な分析対象は\(n\)社(延べ\(N\)観測値)の不均衡パネルデータとなった。なお、外れ値の影響を制御するため、各変数の上下1パーセンタイルにおいてウィンゾライゼーション(winsorization)処理を施している。
3.2 変数の定義
本研究で使用する変数の定義は以下の通りである。 まず、被説明変数となる\(y\)について述べる。\(y\)は企業の〇〇を表す指標であり、本研究ではeolより取得した財務数値を用いて算出している。具体的には、各年度末時点における数値を対数変換したものを用いている。これは、\(y\)の分布が右に裾を引く形状をしており、正規性の仮定を満たすための処置である。
次に、本研究の主たる関心である説明変数\(x\)についてである。\(x\)は、企業の〇〇の程度を測定する変数である。Name (Year) にならい、本研究では各年度における〇〇の値を総資産で除した値として定義した。この値が高いほど、当該企業において\(x\)の要因が強く働いていることを意味する。
最後に、結果に影響を与えうるその他の要因を制御するため、以下の3つのコントロール変数(\(z_1\), \(z_2\), \(z_3\))をモデルに投入する。\(z_1\)は企業規模(Size)である。一般に大企業ほど経営資源が豊富であり、\(y\)に対して正の影響を与える可能性があるため、総資産の自然対数値を代理変数として用いる。
\(z_2\)は財務レバレッジ(Leverage)である。負債比率の高さは企業の財務リスクを示し、経営行動に制約を与える可能性があることから、有利子負債を総資産で除した値を用いる。
\(z_3\)は収益性(Profitability)である。本業の収益力が\(y\)に及ぼす影響を制御するため、総資産利益率(ROA)を採用する。 なお、年度ごとのマクロ経済要因の影響を取り除くため年度ダミーを、業種ごとの固有効果を取り除くため業種ダミーをあわせて導入する。
3.3 分析モデル
以上の変数を用い、\(x\)が\(y\)に与える影響を検証するために、以下の重回帰モデルを最小二乗法で推計する。
\[y_{i,t} = \beta_0 + \beta_1 x_{i,t} + \beta_2 z_{1i,t} + \beta_3 z_{2i,t} + \beta_4 z_{3i,t} + \text{YearDummy} + \text{IndustryDummy} + \epsilon_{i,t}\]
ここで、添字の\(i\)は企業、\(t\)は年度を表す。\(\beta_0\)は定数項、\(\epsilon_{i,t}\)は誤差項である。本研究において最も注目すべきは説明変数\(x\)の係数である\(\beta_1\)であり、仮説が支持されるならば、\(\beta_1\)は統計的に有意な正(または負)の値をとることが予想される。
4. 分析結果
4.1 記述統計量
本分析に使用した各変数の記述統計量は表1の通りである。 被説明変数である\(y\)の平均値は[実際の数値]、標準偏差は[実際の数値]であった。また、主な説明変数である\(x\)の平均値は〇〇を示しており、サンプル企業間において\(x\)の取り組みには一定のばらつきが存在することが確認できる。 コントロール変数に関しては、\(z_1\)(企業規模)の平均値が〇〇、\(z_2\)(財務レバレッジ)の平均値が〇〇であった。これらの数値は、同期間における日本の上場企業の平均的な水準と大きく乖離しておらず、本研究のサンプルが一般的な日本企業の特徴を反映していることを示唆している。観測数は\(N\)であり、回帰分析を行う上で十分なサンプルサイズが確保されているといえる。
表1 記述統計量
| 変数 | 観測数 | 平均値 | 標準偏差 | 最小値 | 第1四分位 | 中央値 | 第3四分位 | 最大値 |
|---|---|---|---|---|---|---|---|---|
| \(y\) | 3,565 | 4.122 | 1.027 | 1.640 | 3.441 | 4.117 | 4.855 | 6.498 |
| \(x\) | 3,565 | 0.060 | 0.042 | 0.005 | 0.028 | 0.050 | 0.080 | 0.206 |
| \(z_1\) | 3,565 | 10.939 | 1.457 | 7.347 | 9.925 | 10.948 | 11.934 | 14.350 |
| \(z_2\) | 3,565 | 0.284 | 0.158 | 0.024 | 0.160 | 0.263 | 0.388 | 0.697 |
| \(z_3\) | 3,565 | 0.040 | 0.048 | -0.074 | 0.008 | 0.041 | 0.073 | 0.157 |
注:\(y\)は〇〇の自然対数値、\(x\)は〇〇 / 総資産、\(z_1\)は総資産の自然対数値、、、のように変数の定義を表の注に書く。各変数は上下1%でウィンゾライズしている。
出所:筆者作成。
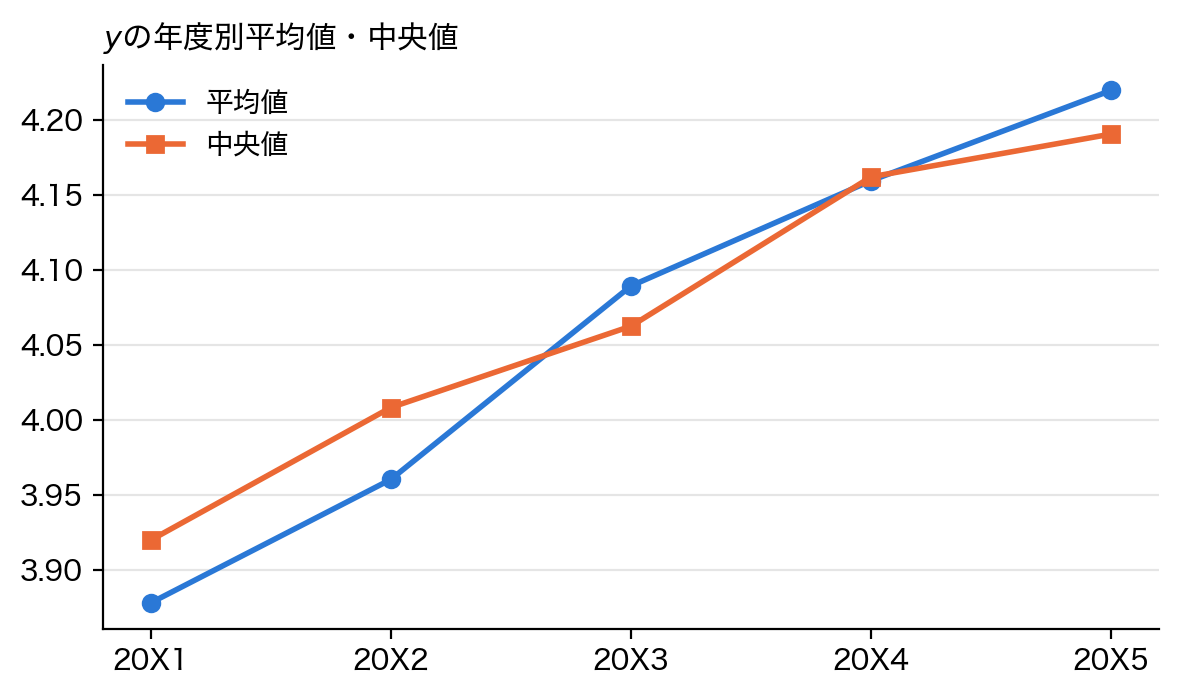
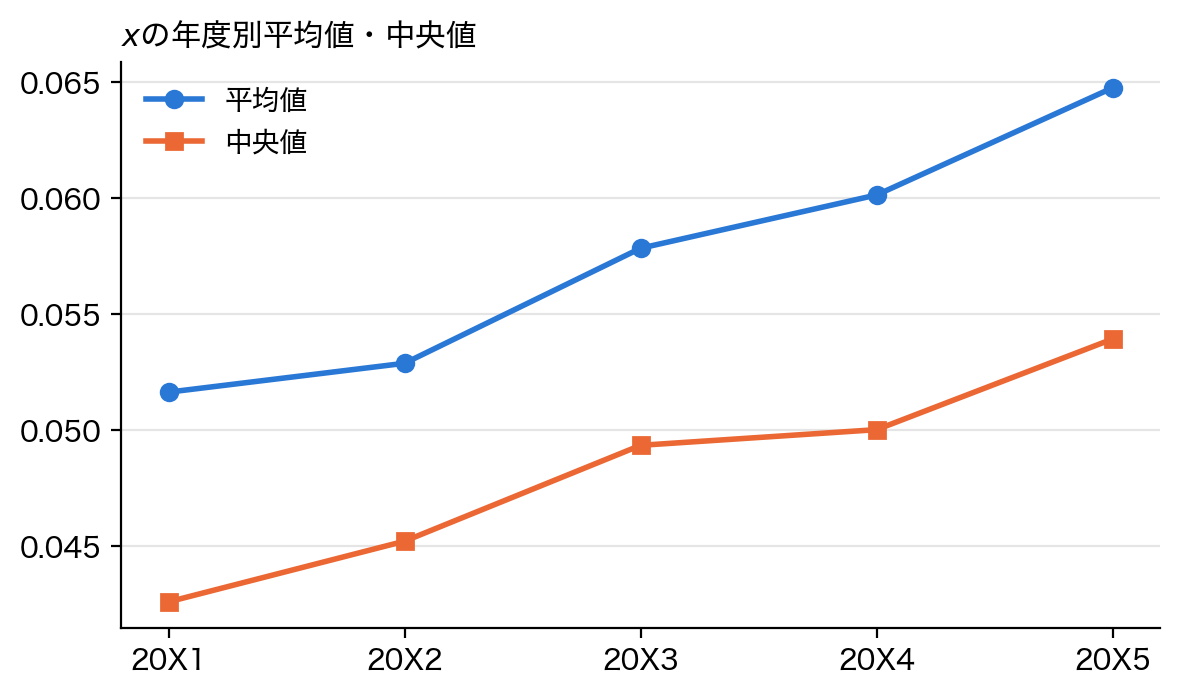
\(y\)と\(x\)の年度別の平均値と中央値の推移を図1と図2に示す。\(y\)は20X1年度の〇〇から20X5年度の〇〇へと上昇傾向にある。\(x\)も同様に上昇しており、分析期間を通じて〇〇への取り組みが広がっていることがうかがえる。
図1 \(y\)の推移
出所:筆者作成。
図2 \(x\)の推移
出所:筆者作成。
次に、\(x\)と\(y\)の関係を散布図で図3に示す。両者の相関係数は〇〇であり、\(x\)が高い企業ほど\(y\)も高い傾向が見られる。ただし、この関係には企業規模などの他の要因の影響も含まれている可能性があるため、次節ではコントロール変数を加えた重回帰分析によって検証する。
図3 \(x\)と\(y\)の散布図
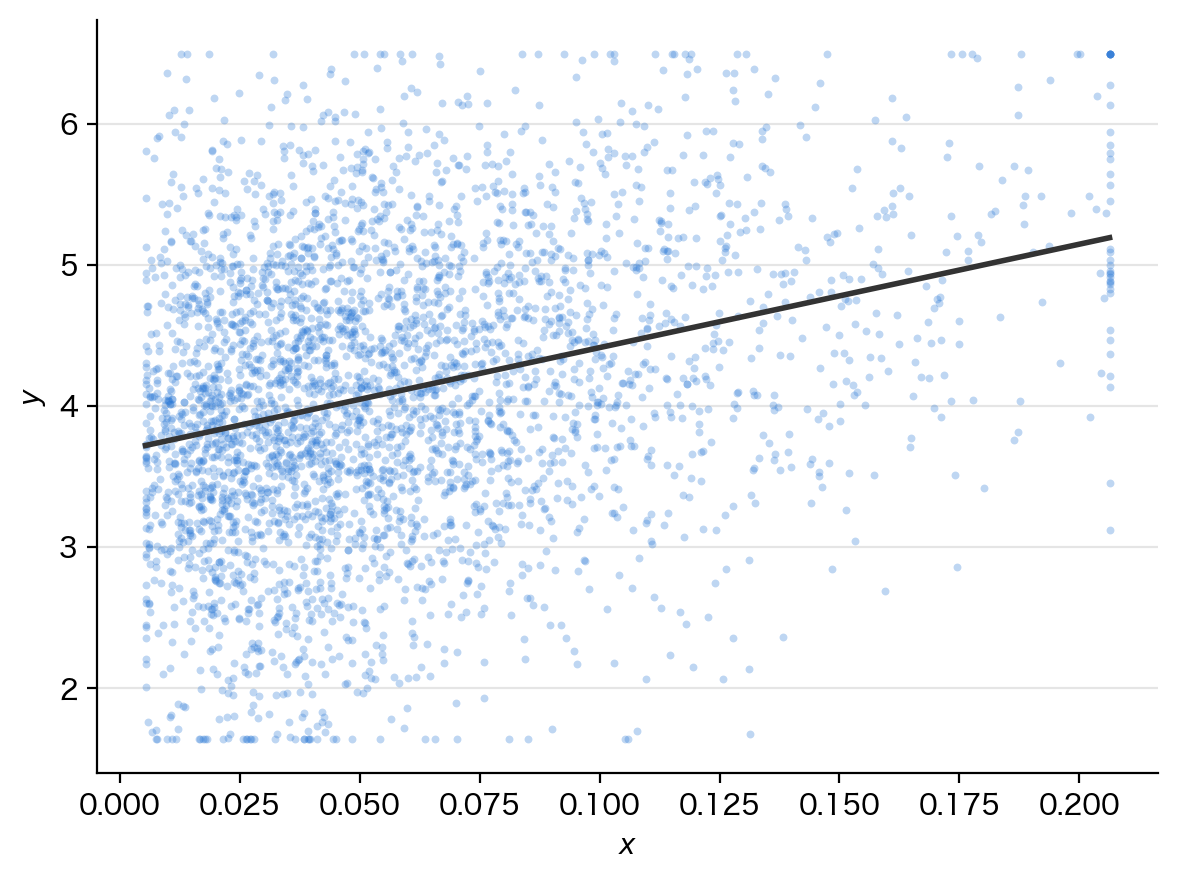
注:直線は最小二乗法による回帰直線を表す。
出所:筆者作成。
4.2 回帰分析の結果
仮説を検証するために行った重回帰分析の結果は表2の通りである。 表2には、\(x\)のみを説明変数とした単回帰のモデル(1)と、コントロール変数、年度ダミー、業種ダミーを加えた重回帰のモデル(2)の結果を示している。モデルの当てはまりの良さを示す自由度修正済み決定係数(Adjusted \(R^2\))は、モデル(1)の〇〇からモデル(2)の〇〇へと上昇しており、コントロール変数の追加によって説明力が高まっていることが確認された。
表2 回帰分析の結果(被説明変数:\(y\))
| (1) | (2) | |
|---|---|---|
| \(x\) | 7.334*** | 6.361*** |
| (0.371) | (0.338) | |
| \(z_1\) | 0.282*** | |
| (0.010) | ||
| \(z_2\) | -0.869*** | |
| (0.091) | ||
| \(z_3\) | 1.600*** | |
| (0.299) | ||
| 定数項 | 3.684*** | 0.606*** |
| (0.030) | (0.131) | |
| 年度ダミー | No | Yes |
| 業種ダミー | No | Yes |
| 観測数 | 3,565 | 3,565 |
| 自由度修正済み決定係数 | 0.090 | 0.276 |
注:上段は係数、下段の括弧内は企業単位のクラスター頑健標準誤差である。***、**、*はそれぞれ1%、5%、10%水準で有意であることを示す。
出所:筆者作成。
まず、単回帰のモデル(1)では、\(x\)の係数は\(\beta = XXX\)であり、1%水準で統計的に有意な正の値を示した。 次に、重回帰のモデル(2)においても、関心変数である\(x\)の係数(\(\beta_1\))は、\(\beta = XXX\) となり、1%水準(\(p < 0.01\))で統計的に有意な正の値を示した。これは、他の要因(\(z\)のこと)を一定とした場合において、\(x\)の値が上昇することが\(y\)の水準を高める効果を持つことを意味している。したがって、本研究が提示した\(x\)は\(y\)に正の影響を与えるという仮説は、統計的に支持された。 なお、コントロール変数については、\(z_1\)(企業規模)が正の有意な値を、\(z_2\)(財務レバレッジ)が負の有意な値を示した。これは、規模が大きく財務基盤が安定している企業ほど\(y\)が高い傾向にあるという従来の知見と整合的な結果である。
5. 考察と結論
5.1 研究結果の要約と解釈
本研究では、\(x\)が\(y\)に与える影響について、日本の上場企業のデータを用いて実証的に分析した。重回帰分析の結果、仮説の通り、\(x\)は\(y\)に対して有意な正の影響を与えることが確認された。 この結果は、先行研究Aの主張と整合的である。すなわち、日本企業においても、\(x\)への取り組みを強化することは、組織の効率性を高め、\(y\)という望ましい成果につながる蓋然性が高いといえる。また、企業規模や収益性といった基本的な財務特性をコントロールした上でもなお\(x\)の係数が有意であったことは、本研究の結果が単なる見かけ上の相関ではないことを示唆している。
5.2 社会的・実務的インプリケーション
本研究の知見は、以下の点において実務的な貢献を有する。 第一に、経営者に対し\(x\)への投資の正当性を提供できる点である。分析結果は、\(x\)を高める努力が、単なるコスト要因ではなく、将来的な\(y\)の向上につながる投資であることを示している。これは、経営者が株主や従業員に対して\(x\)推進の意義を説明する際の強力な根拠となりうる。 第二に、政策的な含意である。産業全体の\(y\)(生産性や健全性など)を底上げするために、行政や業界団体が企業の\(x\)に関する取り組みを支援・推奨することは、合理的かつ有効な施策であると考えられる。
5.3 限界と今後の課題
本研究にはいくつかの限界が存在する。 まず、内生性の問題である。本研究では\(x\)から\(y\)への影響を仮定したが、逆に\(y\)が高い企業だからこそ\(x\)に取り組めるという逆の因果関係が存在する可能性(逆因果)を完全には排除できていない。今後は操作変数法などを用いたより厳密な因果推論が求められる。 次に、データの制約である。本研究ではeolから取得可能な定量データのみを使用したが、\(x\)の質的な側面までは捉えきれていない可能性がある。 これらの課題は残るものの、本研究は\(x\)と\(y\)の関係を大規模なサンプルで実証した点において、今後の議論の出発点となる一定の価値を有するものである。
参考文献リスト
多分ゼミのどこかで書き方の話をしているはず